Турбо Облако добавило DeepSeek-V4.1-Flash и GLM-5.3 в Foundation Model Hub
28 октября 2026 года Турбо Облако включило в Foundation Model Hub модели DeepSeek-V4.1-Flash и GLM-5.3 с оплатой по токенам и контекстом до 1 млн токенов.
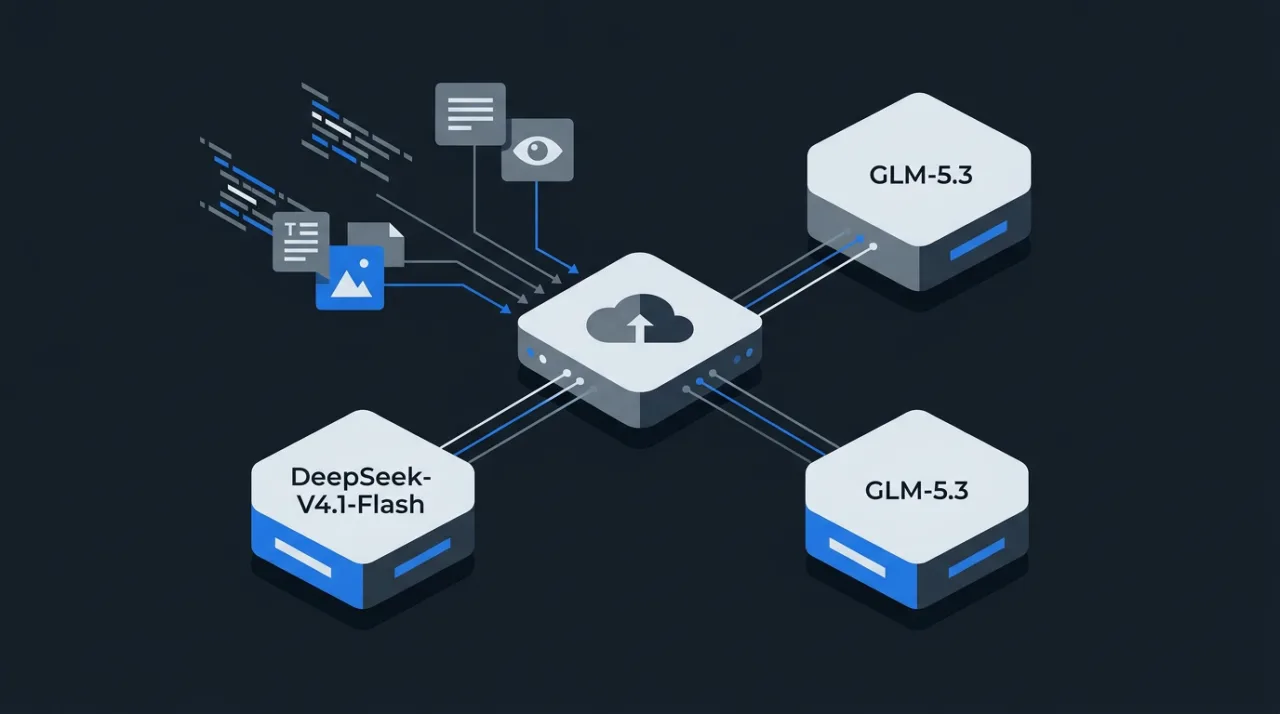
28 октября 2026 года российский облачный провайдер Турбо Облако добавил две новые модели в сервис Foundation Model Hub. DeepSeek-V4.1-Flash и GLM-5.3 стали доступны через API с оплатой за обработанные токены.
Технические характеристики новых моделей в Foundation Model Hub
DeepSeek-V4.1-Flash поддерживает мультимодальный ввод текста и изображений. Контекст модели достигает 1 млн токенов, что позволяет обрабатывать большие документы и длинные цепочки диалогов. Модель ориентирована на задачи с использованием инструментов и создание AI-агентов.
GLM-5.3 работает с текстовыми данными и предлагает контекст до 400 тыс. токенов. По сравнению с предыдущей версией улучшены показатели в программировании и сценариях с автономными агентами. Обе модели используют стандартные тарифы своих линеек без дополнительных надстроек.
Foundation Model Hub предоставляет доступ к готовым языковым моделям через API. Пользователи платят только за входные, выходные и кэшированные токены, без необходимости разворачивать собственную инфраструктуру. Сервис уже содержал более ранние версии DeepSeek и GLM, добавленные в августе 2026 года.
Обновления Inference Platform и GPU-инфраструктуры
Одновременно с расширением каталога моделей Турбо Облако обновило планировщик Inference Platform. Изменения касаются распределения нагрузки при работе с большими контекстами и мультимодальными запросами.
В GPU-виртуальную инфраструктуру добавили карты NVIDIA RTX PRO 6000 Blackwell объёмом 96 ГБ GDDR7. Новые ускорители предназначены для задач инференса и позволяют запускать модели с повышенными требованиями к памяти.
Турбо Облако, входящее в ГК РТК-ЦОД, регулярно обновляет состав доступных моделей. Предыдущие пополнения каталога включали DeepSeek-V4-Flash-0731 и GLM 5.2. Компания не публиковала данные о количестве пользователей сервиса или планах на следующие обновления.
Значение обновления для разработчиков и интеграторов
Добавление моделей с большим контекстом расширяет возможности российских разработчиков при создании приложений, требующих анализа длинных текстов и изображений. Pay-per-token модель снижает порог входа для стартапов и команд без собственной GPU-инфраструктуры.
Мультимодальные возможности DeepSeek-V4.1-Flash и улучшенная агентная производительность GLM-5.3 соответствуют текущим направлениям развития LLM. Интеграция через единый API упрощает переключение между моделями внутри одного проекта.
Частые вопросы
Когда Турбо Облако добавил DeepSeek-V4.1-Flash и GLM-5.3?
Обновление произошло 28 октября 2026 года. Модели стали доступны в сервисе Foundation Model Hub через API.
Какие контексты поддерживают новые модели Турбо Облако?
DeepSeek-V4.1-Flash работает с контекстом до 1 млн токенов, GLM-5.3 — до 400 тыс. токенов.
Нужно ли разворачивать собственные серверы для использования моделей?
Нет. Доступ осуществляется через API Foundation Model Hub с оплатой только за обработанные токены.
Какие ещё обновления вышли вместе с новыми моделями?
Турбо Облако обновило планировщик Inference Platform и добавил карты NVIDIA RTX PRO 6000 Blackwell объёмом 96 ГБ.
Комментарии 1