MiniMax M3.1 Flash выпустила агентную модель с контекстом 1 млн токенов и сниженными затратами
19 октября 2026 года китайская компания MiniMax официально выпустила модель MiniMax M3.1 Flash для агентных задач и программирования с контекстом 1 млн токенов и сниженными ценами на inference.
19 октября 2026 года компания MiniMax объявила о запуске модели MiniMax M3.1 Flash через свой API. Новая агентная модель позиционируется как более быстрая и экономичная альтернатива выпущенной в июне 2026 года версии M3.
Модель доступна под идентификатором MiniMax-M3.1-Flash. Она поддерживает текстовые, графические и видео-входы при текстовом выводе и ориентирована на задачи AI coding и автоматизации процессов.
Технические характеристики MiniMax M3.1 Flash
MiniMax M3.1 Flash использует архитектуру MoE с примерно 428 млрд параметров, из которых активны около 23 млрд. Контекстное окно составляет 1 млн токенов, максимальная длина вывода достигает 524 тысяч токенов. Модель оснащена постоянным механизмом рассуждений с пятью уровнями усилий, где по умолчанию установлен режим Max.
Скорость онлайн-инференса выросла почти в три раза по сравнению с предыдущей версией: пиковая производительность превышает 200 токенов в секунду, медианная — более 170 токенов в секунду. Ценообразование API фиксировано: 0,15 доллара за миллион входных токенов, 0,60 доллара за миллион выходных и 0,015 доллара за миллион кэшированных входных токенов.
Модель уже работала анонимно под названием Space Bunny и обработала более 200 триллионов токенов до официального релиза. Совместимость с конечными точками в стиле OpenAI и Anthropic упрощает интеграцию в существующие инструменты.
Производительность и доступность модели
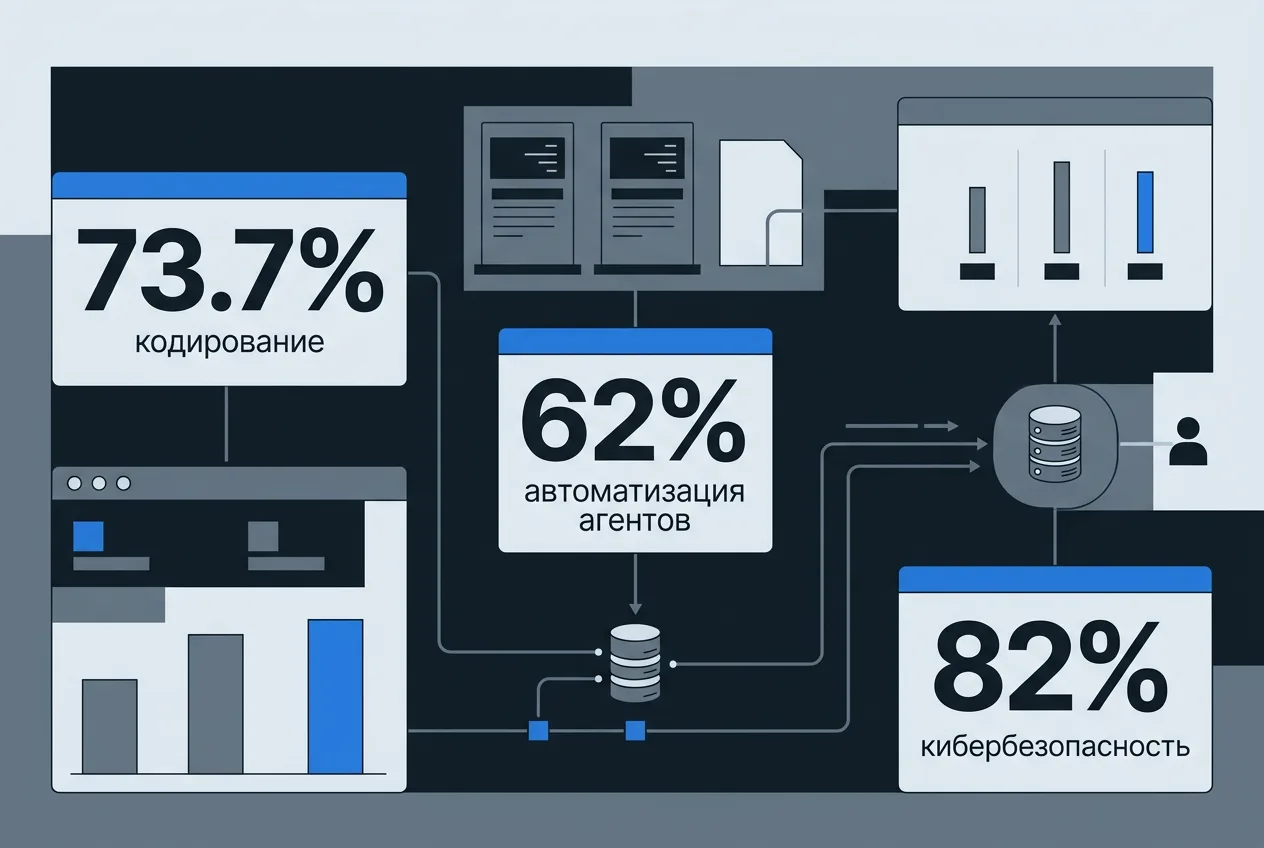
По внутренним бенчмаркам MiniMax, M3.1 Flash показывает 73,7 % на DeepSWE v1.1 в задачах кодирования, 62 % на Automation-Bench для агентных сценариев и 82 % на CyberGym в сфере кибербезопасности. В тесте OSWorld V2 результат составил 61,7 %, что компания называет лучшим показателем среди китайских моделей.
Стоимость использования в агентных задачах снизилась примерно на 70 %. Модель доступна через платформу MiniMax API, подписку M Plan и приложение MiniMax Code. Открытые веса планируется опубликовать около 23 октября 2026 года.
Российские издания Habr, vc.ru и другие отметили интерес к модели среди разработчиков благодаря сочетанию большого контекста, скорости и низкой стоимости инференса. Доступ возможен через официальные каналы MiniMax или сторонние платформы, совместимые с API.
Частые вопросы
Какие входные данные поддерживает MiniMax M3.1 Flash?
Модель принимает текст, изображения и видео, выводит только текст. Это позволяет использовать её для анализа визуальных данных в задачах автоматизации и программирования.
Когда выйдут открытые веса MiniMax M3.1 Flash?
Компания планирует опубликовать веса около 23 октября 2026 года. Точные сроки и условия лицензии будут уточнены позднее.
Насколько быстрее M3.1 Flash по сравнению с предыдущей моделью?
Онлайн-инференс стал почти в три раза быстрее: пиковая скорость превышает 200 токенов в секунду, медианная — более 170 токенов в секунду.
Где доступна модель MiniMax M3.1 Flash российским пользователям?
Модель работает через MiniMax API, подписку M Plan и приложение MiniMax Code. Доступ также возможен через совместимые сторонние платформы.
Комментарии
Комментариев пока нет. Будьте первым!