llm-d 1.0: CNCF выпустил стабильную версию фреймворка для распределённого inference
20 октября 2026 года на PyTorch Conference North America CNCF выпустила llm-d 1.0 — первую production-версию проекта Sandbox для распределённого inference LLM.
20 октября 2026 года на конференции PyTorch Conference North America CNCF представила llm-d 1.0 — первую стабильную версию проекта Sandbox. Фреймворк предназначен для распределённого inference больших языковых моделей на Kubernetes и построен на базе vLLM и SGLang.
Технические возможности llm-d 1.0
Релиз добавляет префиксное кэширование и маршрутизацию с учётом нагрузки через Kubernetes Gateway API Inference Extension. Реализована разъединённая обработка prefill и decode, а также иерархическое вытеснение KV-cache на HBM, CPU и SSD. Поддерживается автоматическое масштабирование с учётом трафика и аппаратного обеспечения, а также широкое экспертное распараллеливание.
Система работает с ускорителями NVIDIA, AMD, Intel GPU и Google TPU. Проект распространяется под лицензией Apache 2.0. В разработке участвовали более 500 специалистов из 25 организаций, среди них Red Hat, IBM Research, Google Cloud, CoreWeave и NVIDIA.
В версии 1.0 добавлены механизмы multi-tenant QoS, отказоустойчивость роутера с горячей заменой и нулевым временем простоя, а также DisaggregatedSet для координированных обновлений prefill и decode. Стабилизирован v1 API конфигурации и добавлена маршрутизация с учётом сессий агентов.
Результаты внедрения в production
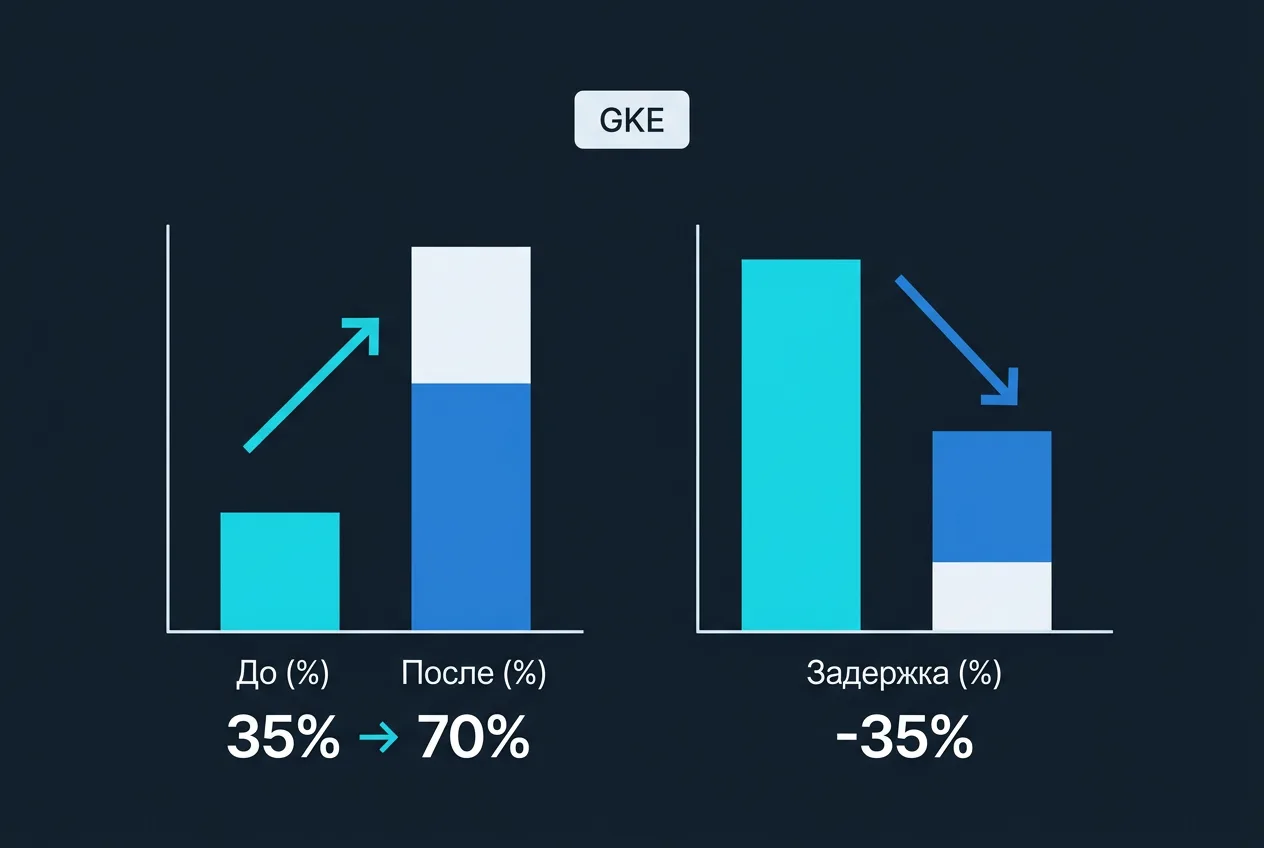
Google Cloud GKE Inference Gateway после интеграции llm-d 1.0 увеличила hit rate префиксного кэша с 35 до 70 процентов и сократила TTFT более чем на 35 процентов. Пропускная способность выросла в 2,4–2,9 раза в отдельных сценариях.
IBM и Red Hat запустили модель GLM-5.2 на 544 ускорителях H100 и обслуживали около 3000 параллельных агентов кодирования. Пиковая производительность превысила 6,6 млн выходных токенов в минуту при стоимости на 5–10 раз ниже коммерческих API. Tesla и Red Hat зафиксировали троекратный рост выходной пропускной способности и двукратное снижение TTFT на Llama 3.1 70B с AMD MI300X. AWS сообщила о приросте до 70 процентов токенов в секунду на SageMaker HyperPod.
По состоянию на 21 октября 2026 года проект насчитывает 3253 контрибьютора и 3711 звёзд на GitHub. CNCF оценивает здоровье проекта как Healthy (79). Следующие этапы включают интеграцию в управляемые сервисы GKE и Red Hat AI, адаптацию к новым моделям и оборудованию, а также развитие инструментов для агентных и RL-нагрузок.
Частые вопросы
Что нового появилось в llm-d 1.0
Релиз добавил multi-tenant QoS, отказоустойчивый роутер с горячей заменой, DisaggregatedSet и стабильный v1 API конфигурации. Улучшена маршрутизация с учётом сессий агентов.
Какие ускорители поддерживает llm-d 1.0
Фреймворк работает с NVIDIA, AMD, Intel GPU и Google TPU. Заявлена поддержка модели «any model, any accelerator, any cloud».
Какие результаты показали пользователи llm-d 1.0
Google Cloud зафиксировала рост hit rate кэша до 70 процентов и снижение TTFT более чем на 35 процентов. IBM и Red Hat обслуживали 3000 агентов на 544 H100 с существенным снижением стоимости.
Когда llm-d вошёл в CNCF Sandbox
Проект приняли в CNCF Sandbox 12 марта 2026 года. Первая стабильная версия 1.0 вышла 20 октября 2026 года.
Комментарии
Комментариев пока нет. Будьте первым!